TL;DR : L’essentiel
- L’agence européenne pour la cybersécurité et le CERT-EU ont conduit ces audits en août 2026 sur 25 logiciels déjà publiés en open source et 2 projets sur le point de le devenir.
- Les responsables des logiciels avaient examiné 88 signalements à la sortie du rapport, avec un taux de 95% de vrais positifs et quatre nouveaux identifiants CVE attribués.
- Le harnais spécialisé Vigilo du CERT-EU obtient des niveaux de gravité validés par les humains dans 74% des cas, contre 60% pour les agents de programmation généralistes.
- L’ENISA recommande d’exécuter ces outils dans un environnement isolé, de vérifier manuellement chaque alerte avant divulgation et de relire tout correctif généré automatiquement avant son application.
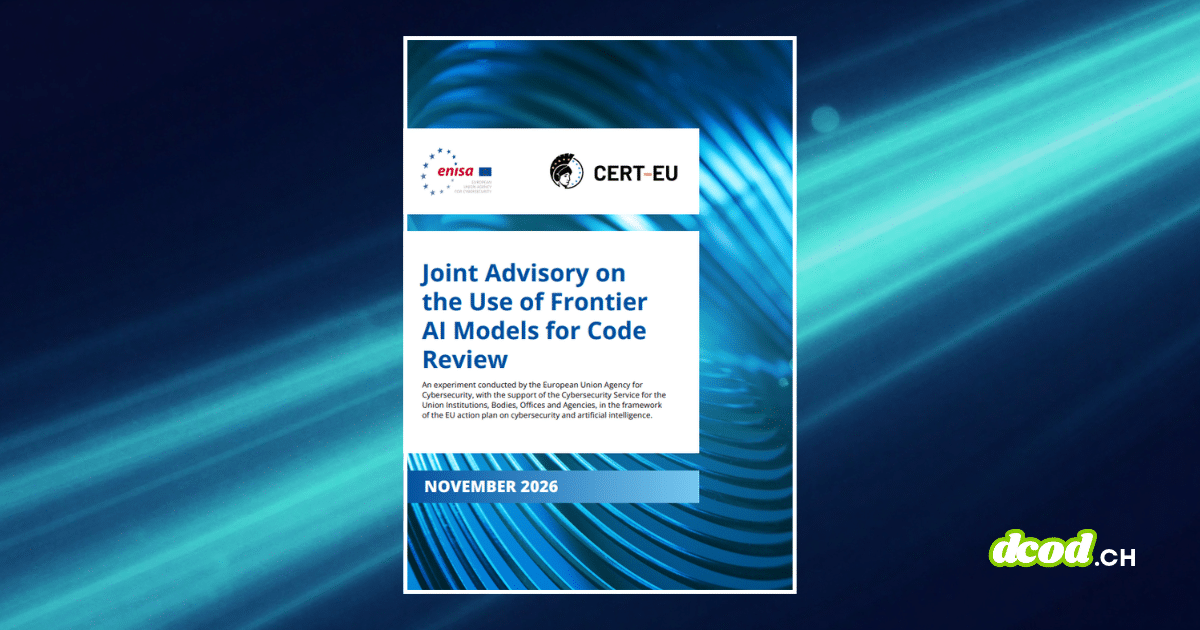
L’agence européenne pour la cybersécurité (ENISA) et le CERT-EU ont testé des modèles d’intelligence artificielle avancés pour la revue de code de 27 logiciels open source européens. Publiée le 12 novembre 2026 dans un avis conjoint, cette expérimentation a permis de détecter 220 problèmes de sécurité potentiels. Les résultats confirment que ces outils accélèrent la recherche de failles, mais ils ne remplacent pas l’expertise humaine pour évaluer les risques réels. Privés du contexte de production, les modèles surestiment souvent la gravité des anomalies et imposent un travail de tri conséquent aux développeurs.
L’ENISA et le CERT-EU testent plusieurs agents IA en environnement isolé
Les deux organismes européens ont mené ces audits en août 2026 dans le cadre du plan d’action de l’Union européenne sur la cybersécurité et l’intelligence artificielle. La sélection comprenait 25 bases de code déjà publiées en open source et 2 projets sur le point de l’être, tous utilisés par les institutions européennes. Les équipes ont placé chaque outil dans un conteneur isolé afin d’empêcher les agents d’accéder à des systèmes externes ou d’exécuter des commandes non autorisées. Les modèles n’ont analysé que le code source brut, sans aucune information sur l’architecture réseau ni sur la configuration en production.
L’expérimentation a mobilisé plusieurs modèles récents, dont GPT-5.5 Cyber, GPT-5.6 Cyber et GPT-6 Astra d’OpenAI, ainsi que Mythos 5 d’Anthropic. Les analystes ont comparé deux approches techniques distinctes pour piloter ces modèles lors de l’audit de code. La première associe des agents de programmation généralistes, comme Codex et OpenCode, à des modules spécialisés développés par l’ENISA pour guider l’audit et formater les rapports. La seconde repose sur Vigilo, un outil open source conçu par le CERT-EU qui coordonne plusieurs agents dédiés à des catégories précises de failles.
L'essentiel Cybersécurité, IA & Tech
Rejoignez la communauté. 3 fois par semaine, recevez l'analyse des tendances par Marc Barbezat. Pas de spam, juste de l'info.
Les modèles détectent des failles réelles mais surestiment leur gravité
L’analyse des 27 dépôts a consommé plus de 611 millions de jetons, pour un coût théorique estimé à environ 6’650 euros. Après suppression des doublons, l’ENISA et le CERT-EU ont transmis 220 signalements aux responsables des logiciels concernés. Au moment de la publication du rapport, les développeurs avaient terminé l’examen de 88 signalements, soit 40% du total. Parmi ces cas vérifiés, 95% se sont révélés exacts et quatre nouvelles références de vulnérabilités CVE ont été attribuées.
Les modèles ont toutefois tendance à exagérer la sévérité des problèmes parce qu’ils ignorent les protections déjà en place sur les serveurs. Les trois failles classées critiques par l’intelligence artificielle ont toutes été revues à la baisse après vérification humaine. L’outil Vigilo limite mieux cet écart grâce à une étape interne de critique contradictoire qui réévalue chaque alerte avant le rapport final. Les responsables du code ont confirmé la gravité estimée par Vigilo dans 74% des cas, contre 60% pour les agents généralistes.
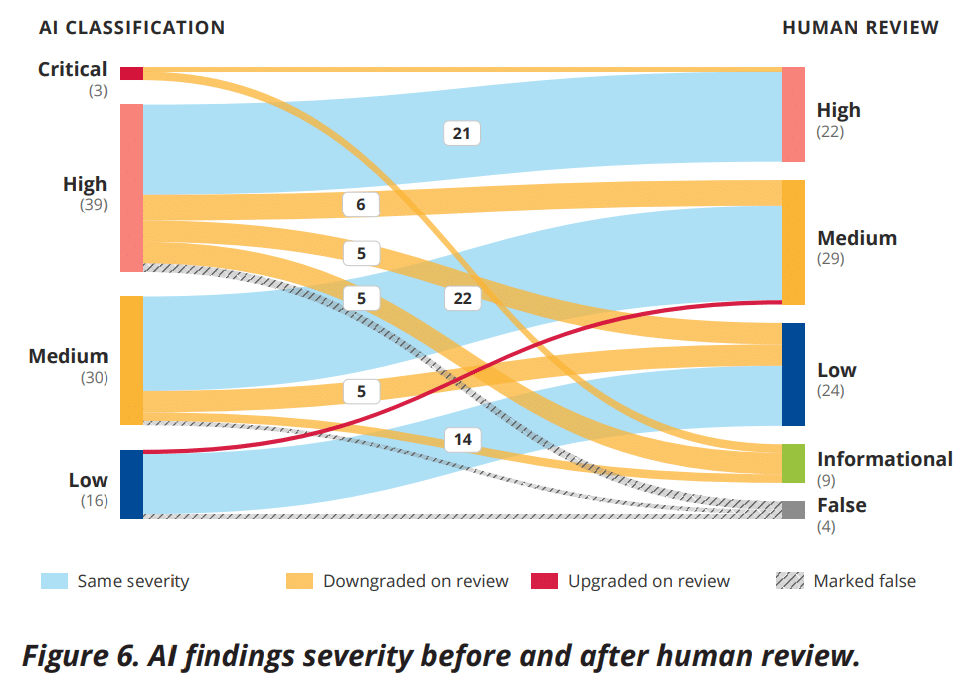
Cette précision supplémentaire exige davantage de temps de calcul et de jetons que les agents généralistes, plus rapides et moins coûteux. Dans les deux cas, le tri des alertes reste un goulot d’étranglement pour les équipes techniques. Trois mois après les tests, 60% des signalements attendaient encore une validation humaine faute de temps disponible chez les mainteneurs.
Analyse
L’ENISA a analysé un total de 27 bases de code (dont 25 étaient déjà en open source et 2 en passe de le devenir). Au sein de ces 27 bases de code, les modèles utilisés ont permis d’identifier 220 problèmes potentiels. L’expérience montre que l’IA peut contribuer à accélérer la revue de code — ce qui n’a rien de nouveau — mais qu’elle ne saurait remplacer le jugement humain. En l’absence de contexte de déploiement, les modèles peuvent surestimer l’impact concret ou la gravité d’un problème ; par ailleurs, le volume de résultats qu’ils génèrent peut faire peser une charge de travail importante sur les responsables du code.

L’avis européen encadre l’usage de l’IA par sept étapes de contrôle
Pour éviter de saturer les développeurs, l’ENISA recommande aux chercheurs de filtrer et de reproduire les failles avant toute notification. Les organismes doivent également exécuter ces audits dans un environnement cloisonné, avec un contrôle strict des accès réseau et une surveillance continue. Chaque vulnérabilité confirmée doit ensuite suivre les canaux officiels de divulgation coordonnée, comme le CERT-EU pour les institutions européennes. Les auteurs du rapport déconseillent aussi d’appliquer automatiquement les correctifs générés par les modèles sans relecture par un développeur.
L’avis détaille un cycle en sept étapes qui combine l’outillage automatisé et la validation humaine à chaque phase. Les agents généralistes conviennent aux contrôles rapides lors des modifications courantes du code, notamment pour vérifier du code produit par assistance automatique. Les harnais spécialisés comme Vigilo répondent mieux aux audits approfondis d’un dépôt complet avant sa mise en service. Le document invite enfin les organisations à former leurs équipes sécurité pour maîtriser ces outils et accélérer le tri des résultats.
L’expérimentation de l’ENISA et du CERT-EU confirme que les modèles avancés accélèrent la détection des failles dans les logiciels open source. Ces gains de vitesse ne réduisent pas le besoin d’expertise humaine, car seuls les responsables du code connaissent le contexte réel de déploiement. Sans un filtrage rigoureux en amont et des ressources dédiées au tri, l’automatisation risque surtout de déplacer la charge de travail vers les équipes chargées de corriger les logiciels.
Questions fréquentes sur la revue de code par intelligence artificielle
Pourquoi les modèles d’intelligence artificielle surestiment-ils la gravité des failles ?
Les modèles analysent uniquement le code source sans connaître l’environnement réel dans lequel le logiciel fonctionne. Ils ignorent les contrôles externes, les niveaux de privilèges et l’exposition réseau de l’application. Un expert humain doit donc vérifier si la faiblesse est réellement exploitable en production.
Quelle différence sépare l’outil Vigilo des agents de programmation généralistes ?
Vigilo est un harnais spécialisé du CERT-EU qui coordonne plusieurs agents dédiés chacun à un type de faille et intègre une étape de critique contradictoire. Cette architecture produit des évaluations de gravité plus proches du jugement humain, mais demande plus de temps et de jetons. Les agents généralistes sont plus rapides et moins coûteux pour des vérifications courantes.
Quels risques pose l’exécution d’agents IA lors d’un audit de sécurité ?
Les agents modernes peuvent lire des dépôts de code, installer des dépendances, exécuter des commandes et contacter des services distants. L’ENISA recommande donc de les exécuter dans un conteneur isolé avec une segmentation réseau stricte. Cette précaution évite toute fuite de données ou action non désirée sur l’infrastructure hôte.
L’intelligence artificielle peut-elle corriger automatiquement les vulnérabilités détectées ?
Certains outils comme Vigilo génèrent des propositions de correctifs sur une branche séparée du dépôt. L’ENISA et le CERT-EU déconseillent toutefois d’appliquer ces modifications sans relecture humaine. Un correctif automatisé mal conçu peut introduire de nouveaux défauts ou laisser subsister la cause initiale du problème.
Pour approfondir le sujet
Le rapport de cybersécurité 2026 de l'ENISA fixe cinq priorités
Ce bilan sur l'état de la cybersécurité dans l'Union introduit une boussole d'action. Les entreprises doivent accélérer la protection de leurs prestataires. Lire la suite
Une lecture utile ?
Un café, c'est une façon simple de dire merci pour la veille. Sans abonnement, sans engagement.