TL;DR: Das Wichtigste
- Die Europäische Agentur für Cybersicherheit und das CERT-EU führten diese Prüfungen im August 2026 bei 25 bereits als Open-Source-Software veröffentlichten Programmen sowie bei zwei Projekten durch, die kurz vor der Veröffentlichung als Open-Source-Software standen.
- Die Verantwortlichen der Softwareprojekte hatten bis zur Veröffentlichung des Berichts 88 Meldungen geprüft, wobei die Rate der echten Treffer bei 95 % lag und vier neue CVE-Kennungen vergeben wurden.
- Das spezialisierte Tool „Vigilo“ des CERT-EU erzielte in 74 % der Fälle von Menschen validierte Schweregrade, gegenüber 60 % bei allgemeinen Programmier-Tools.
- Die ENISA empfiehlt, diese Tools in einer isolierten Umgebung auszuführen, jeden Alarm vor der Weitergabe manuell zu überprüfen und jeden automatisch generierten Patch vor dessen Anwendung noch einmal zu überprüfen.
Die Europäische Agentur für Cybersicherheit (ENISA) und das CERT-EU haben fortschrittliche Modelle künstlicher Intelligenz zur Codeüberprüfung von 27 europäischen Open-Source-Softwareprogrammen getestet. Dieser Versuch, der am 12. November 2026 in einer gemeinsamen Stellungnahme veröffentlicht wurde, ermöglichte die Erkennung von 220 potenziellen Sicherheitsproblemen. Die Ergebnisse bestätigen, dass diese Tools die Suche nach Schwachstellen beschleunigen, jedoch das menschliche Fachwissen bei der Bewertung der tatsächlichen Risiken nicht ersetzen können. Ohne den Produktionskontext überschätzen die Modelle häufig die Schwere der Anomalien und erfordern von den Entwicklern einen erheblichen Aufwand bei der Einordnung.
Die ENISA und das CERT-EU testen mehrere KI-Agenten in einer isolierten Umgebung
Die beiden europäischen Organisationen führten diese Prüfungen im August 2026 im Rahmen des Aktionsplans der Europäischen Union zu Cybersicherheit und künstlicher Intelligenz durch. Die Auswahl umfasste 25 bereits als Open Source veröffentlichte Code-Repositorien sowie zwei Projekte, deren Veröffentlichung kurz bevorstand; alle werden von den europäischen Institutionen genutzt. Die Teams haben jedes Tool in einen isolierten Container verschoben, um zu verhindern, dass die Agenten auf externe Systeme zugreifen oder unbefugte Befehle ausführen. Die Modelle analysierten ausschliesslich den rohen Quellcode, ohne jegliche Informationen zur Netzwerkarchitektur oder zur Konfiguration in der Produktionsumgebung.
Das Wichtigste zu Cybersicherheit, KI & Tech
Werden Sie Teil der Community. 3-mal pro Woche erhalten Sie die Trendanalyse von Marc Barbezat (auf Französisch). Kein Spam, nur Informationen.
Im Rahmen des Experiments kamen mehrere aktuelle Modelle zum Einsatz, darunter GPT-5.5 Cyber, GPT-5.6 Cyber und GPT-6 Astra von OpenAI sowie Mythos 5 von Anthropic. Die Analysten verglichen zwei unterschiedliche technische Ansätze zur Steuerung dieser Modelle während der Code-Prüfung. Der erste Ansatz kombiniert allgemeine Programmieragenten wie Codex und OpenCode mit von der ENISA entwickelten Spezialmodulen, um die Prüfung zu steuern und die Berichte zu formatieren. Der zweite Ansatz basiert auf Vigilo, einem vom CERT-EU entwickelten Open-Source-Tool, das mehrere Agenten koordiniert, die auf bestimmte Kategorien von Sicherheitslücken spezialisiert sind.
Die Modelle erkennen zwar tatsächliche Schwachstellen, überschätzen jedoch deren Schweregrad
Die Analyse der 27 Meldungen beanspruchte mehr als 611 Millionen Token, was theoretischen Kosten von schätzungsweise rund 6.650 Euro entspricht. Nach dem Entfernen von Duplikaten leiteten die ENISA und das CERT-EU 220 Meldungen an die Verantwortlichen der betroffenen Software weiter. Zum Zeitpunkt der Veröffentlichung des Berichts hatten die Entwickler die Prüfung von 88 Meldungen abgeschlossen, was 40 % der Gesamtzahl entspricht. Von diesen überprüften Fällen erwiesen sich 95 % als zutreffend, und es wurden vier neue CVE-Referenzen für Sicherheitslücken vergeben.
Die Modelle neigen jedoch dazu, die Schwere der Probleme zu übertreiben, da sie die bereits auf den Servern vorhandenen Schutzmassnahmen ausser Acht lassen. Die drei Schwachstellen, die von der künstlichen Intelligenz als kritisch eingestuft wurden, wurden nach einer manuellen Überprüfung alle herabgestuft. Das Tool Vigilo gleicht diese Diskrepanz besser aus, da es über einen internen Prozess der gegenseitigen Überprüfung verfügt, bei dem jeder Alarm vor dem Abschlussbericht neu bewertet wird. Die für den Code Verantwortlichen bestätigten die von Vigilo geschätzte Schwere in 74 % der Fälle, gegenüber 60 % bei den allgemeinen Sicherheitsmitarbeitern.
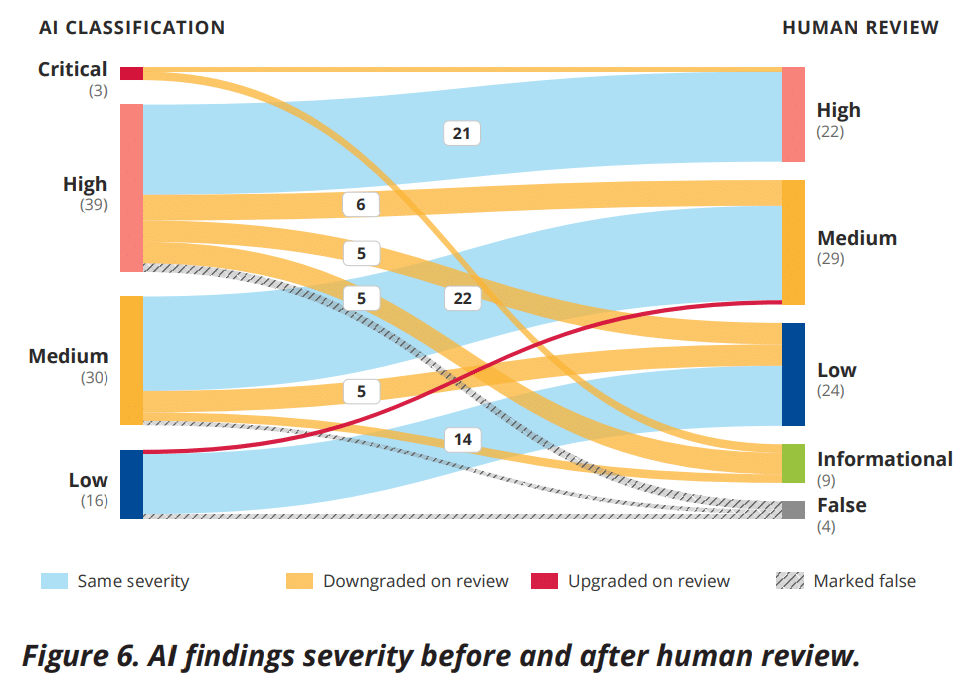
Diese zusätzliche Genauigkeit erfordert mehr Rechenzeit und mehr Tokens als die schnelleren und kostengünstigeren Allround-Agenten. In beiden Fällen stellt die Sortierung der Warnmeldungen weiterhin einen Engpass für die technischen Teams dar. Drei Monate nach den Tests warteten 60 % der Meldungen noch immer auf eine manuelle Überprüfung, da den Systemadministratoren die Zeit dafür fehlte.
Analyse
Die ENISA hat insgesamt 27 Code-Repositories analysiert (von denen 25 bereits Open Source waren und 2 kurz davor standen, Open Source zu werden). Innerhalb dieser 27 Code-Repositorien konnten mithilfe der verwendeten Modelle 220 potenzielle Probleme identifiziert werden. Die Erfahrung zeigt, dass KI dazu beitragen kann, die Code-Überprüfung zu beschleunigen – was nichts Neues ist –, dass sie jedoch das menschliche Urteilsvermögen nicht ersetzen kann. Ohne Kenntnis des Einsatzkontexts können die Modelle die konkreten Auswirkungen oder den Schweregrad eines Problems überschätzen; zudem kann die Menge der von ihnen generierten Ergebnisse eine erhebliche Arbeitsbelastung für die für den Code Verantwortlichen darstellen.

Die europäische Stellungnahme regelt den Einsatz von KI anhand von sieben Kontrollschritten
Um eine Überlastung der Entwickler zu vermeiden, empfiehlt die ENISA den Forschern, die Sicherheitslücken vor einer Meldung zu filtern und zu reproduzieren. Die Organisationen sollten diese Prüfungen zudem in einer isolierten Umgebung durchführen, mit strenger Kontrolle der Netzwerkzugriffe und kontinuierlicher Überwachung. Jede bestätigte Sicherheitslücke muss anschliessend über die offiziellen Kanäle zur koordinierten Offenlegung gemeldet werden, wie beispielsweise das CERT-EU für die europäischen Institutionen. Die Autoren des Berichts raten zudem davon ab, die von den Modellen generierten Patches automatisch anzuwenden, ohne dass diese zuvor von einem Entwickler überprüft wurden.
In der Stellungnahme wird ein siebenstufiger Zyklus beschrieben, der in jeder Phase automatisierte Werkzeuge mit einer Überprüfung durch den Menschen kombiniert. Allgemeinqualifizierte Mitarbeiter eignen sich für schnelle Überprüfungen bei routinemässigen Codeänderungen, insbesondere zur Überprüfung von Code, der durch automatische Unterstützung erstellt wurde. Spezialisierte Tools wie Vigilo eignen sich besser für eingehende Prüfungen eines gesamten Repositorys vor dessen Inbetriebnahme. Schliesslich fordert das Dokument die Organisationen dazu auf, ihre Sicherheitsteams zu schulen, damit diese den Umgang mit diesen Tools beherrschen und die Auswertung der Ergebnisse beschleunigen können.
Die Versuche der ENISA und des CERT-EU bestätigen, dass fortschrittliche Modelle die Erkennung von Schwachstellen in Open-Source-Software beschleunigen. Diese Geschwindigkeitsgewinne mindern jedoch nicht den Bedarf an menschlichem Fachwissen, da nur die für den Code Verantwortlichen den tatsächlichen Einsatzkontext kennen. Ohne eine strenge Vorabprüfung und spezielle Ressourcen für die Sortierung besteht bei der Automatisierung vor allem die Gefahr, dass die Arbeitslast auf die Teams verlagert wird, die für die Behebung der Softwarefehler zuständig sind.
Häufig gestellte Fragen zur Code-Prüfung mittels künstlicher Intelligenz
Warum überschätzen Modelle der künstlichen Intelligenz die Schwere von Sicherheitslücken?
Die Modelle analysieren ausschliesslich den Quellcode, ohne die tatsächliche Umgebung zu kennen, in der die Software ausgeführt wird. Sie berücksichtigen weder externe Kontrollen noch Berechtigungsstufen oder die Netzwerkexposition der Anwendung. Daher muss ein menschlicher Experte überprüfen, ob die Schwachstelle in der Produktionsumgebung tatsächlich ausnutzbar ist.
Inwiefern unterscheidet sich das Tool „Vigilo“ von allgemeinen Planungswerkzeugen?
Vigilo ist ein spezielles Tool des CERT-EU, das mehrere Agenten koordiniert, von denen jeder auf eine bestimmte Art von Sicherheitslücke spezialisiert ist, und das einen Schritt der kritischen Gegenprüfung beinhaltet. Diese Architektur liefert Schweregradbewertungen, die der menschlichen Einschätzung näher kommen, erfordert jedoch mehr Zeit und Ressourcen. Allgemeine Agenten sind bei routinemässigen Überprüfungen schneller und kostengünstiger.
Welche Risiken birgt die Ausführung von KI-Agenten im Rahmen eines Sicherheitsaudits?
Moderne Agenten können Code-Repositories auslesen, Abhängigkeiten installieren, Befehle ausführen und Remote-Dienste aufrufen. Die ENISA empfiehlt daher, diese in einem isolierten Container mit strikter Netzwerksegmentierung auszuführen. Diese Vorsichtsmassnahme verhindert jeglichen Datenverlust oder unerwünschte Aktionen auf der Host-Infrastruktur.
Kann künstliche Intelligenz die erkannten Sicherheitslücken automatisch beheben?
Bestimmte Tools wie Vigilo generieren Korrekturvorschläge in einem separaten Zweig des Repositorys. Die ENISA und das CERT-EU raten jedoch davon ab, diese Änderungen ohne menschliche Überprüfung anzuwenden. Ein schlecht konzipierter automatisierter Patch kann neue Fehler verursachen oder die ursprüngliche Ursache des Problems unberücksichtigt lassen.
Weitere Informationen zu diesem Thema
Der ENISA-Bericht zur Cybersicherheit 2026 legt fünf Prioritäten fest
Diese Bestandsaufnahme zur Lage der Cybersicherheit in der Union liefert einen Orientierungsrahmen für Massnahmen. Unternehmen müssen den Schutz ihrer Dienstleister vorantreiben. Weiterlesen
Hat Ihnen der Beitrag geholfen?
Ein Kaffee ist ein einfaches Dankeschön für das Monitoring. Ohne Abo, ohne Verpflichtung.